공개 · 2026-11-06 07:00 (한국 시간)
짧은 답변
B-tree 인덱스는 키를 정렬된 구조로 관리해 동등 조건이나 범위 조건에 맞는 위치를 찾는 데 도움을 줍니다. 하지만 별도의 저장 공간이 필요하고 데이터 변경 시 인덱스도 관리해야 합니다. 조회 조건과 데이터 분포에 따라 이득이 달라져 모든 열에 만드는 것이 최선은 아닙니다.
더 알아보기
필요한 범위를 좁히기
상품 가격이 30 이상 40 미만인 행을 찾는다고 가정해 보겠습니다. 테이블을 전부 살펴보는 대신 가격 인덱스에서 시작 위치를 찾고, 조건 범위를 따라가며 후보를 모을 수 있습니다. 그림에서는 이 과정을 사서가 정렬된 찾아보기로 원하는 서가를 찾는 장면에 비유했습니다.
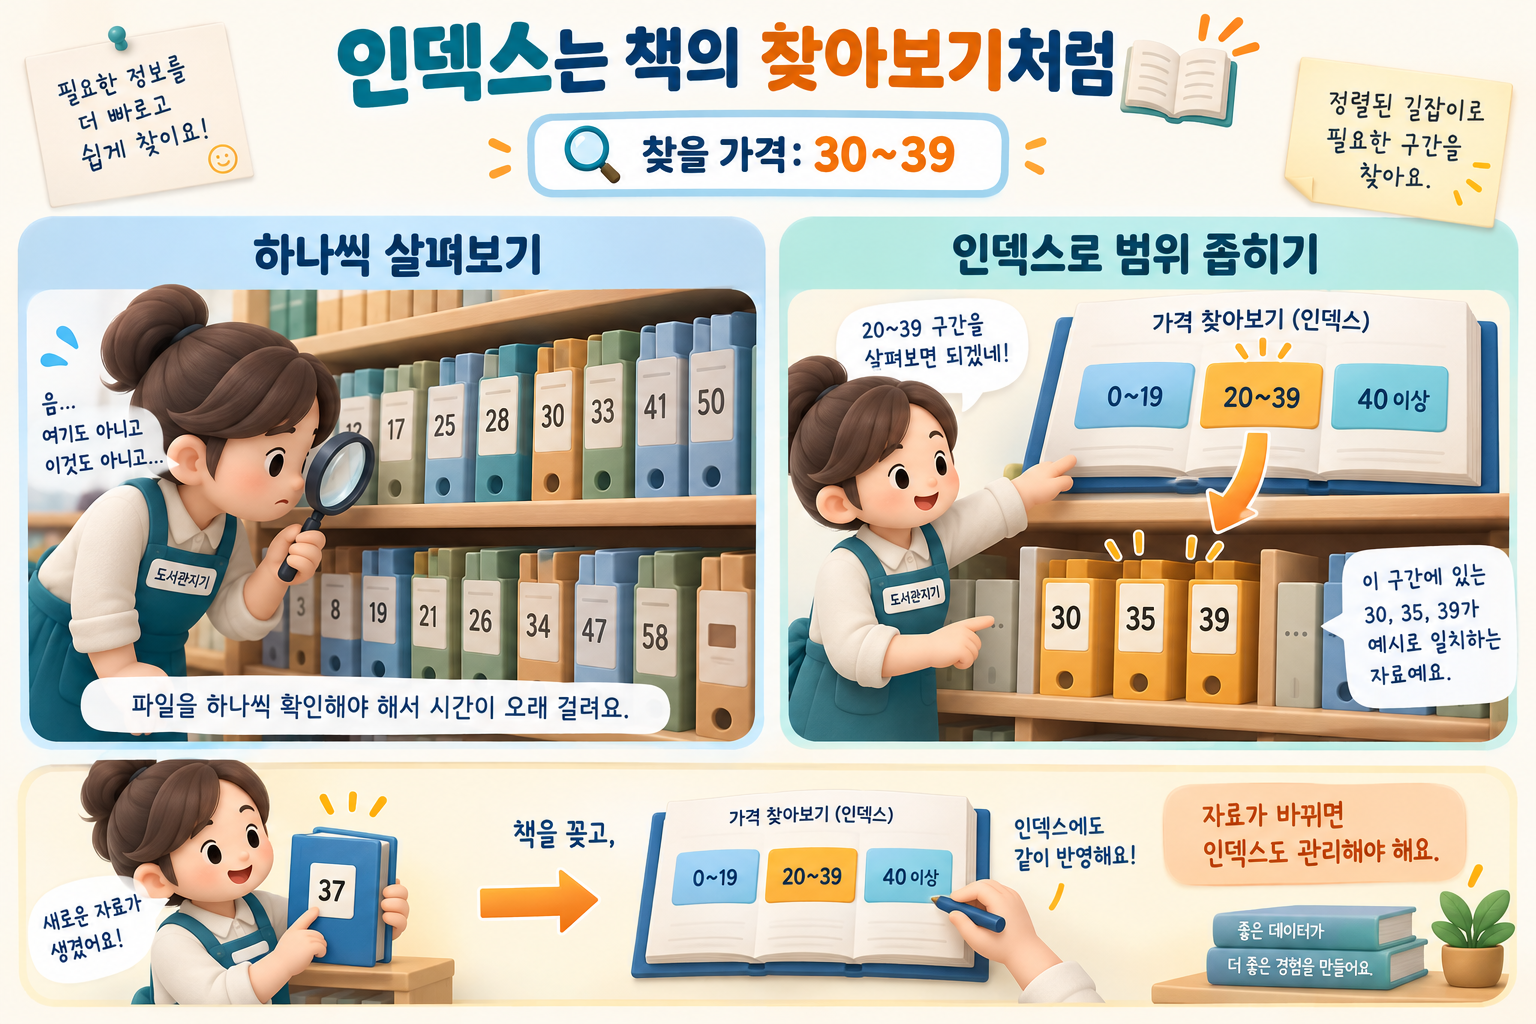
책의 찾아보기는 인덱스에, 서가의 파일은 데이터 행에 대응하는 비유입니다. 가격 30·35·39는 조건에 맞는 예시이며, 실제 B-tree 노드나 저장 순서를 그린 것은 아닙니다.
읽기가 빨라져도 쓰기는 더 일할 수 있어요
행을 추가하거나 인덱스 키를 바꾸면 인덱스 구조에도 반영해야 합니다. 따라서 읽기 성능만 보고 인덱스를 늘리면 저장 공간과 쓰기 비용이 커질 수 있습니다. 인덱스를 통해 행 위치를 찾은 뒤 실제 테이블을 읽는 비용도 고려해야 합니다.
인덱스가 있어도 사용하지 않을 수 있어요
조건에 맞는 행이 테이블 대부분이라면 순차 스캔이 더 유리할 수 있습니다. 실제 쿼리 계획과 실행 시간을 확인해야 합니다. PostgreSQL의 B-tree는 동등·범위 비교에 활용되며, 모든 종류의 검색을 하나의 인덱스로 해결하지는 않습니다.